Figure 1은 그림보다 배치의 문제다
대부분의 연구자는 Figure 1에 무엇을 넣을지 이미 머릿속에 정리해 둔 채로 그림 도구를 엽니다. 정작 시간이 많이 드는 부분은 그다음입니다. 모듈이 무엇이고 화살표가 어떻게 이어지고 어떤 예시를 쓸지는 이미 알고 있지만, 정작 없는 것은 뼈대입니다. 시선이 어느 방향으로 흐르는지, 시각적 중심에 무엇을 둘지, 패널이 몇 개인지 하는 부분입니다.
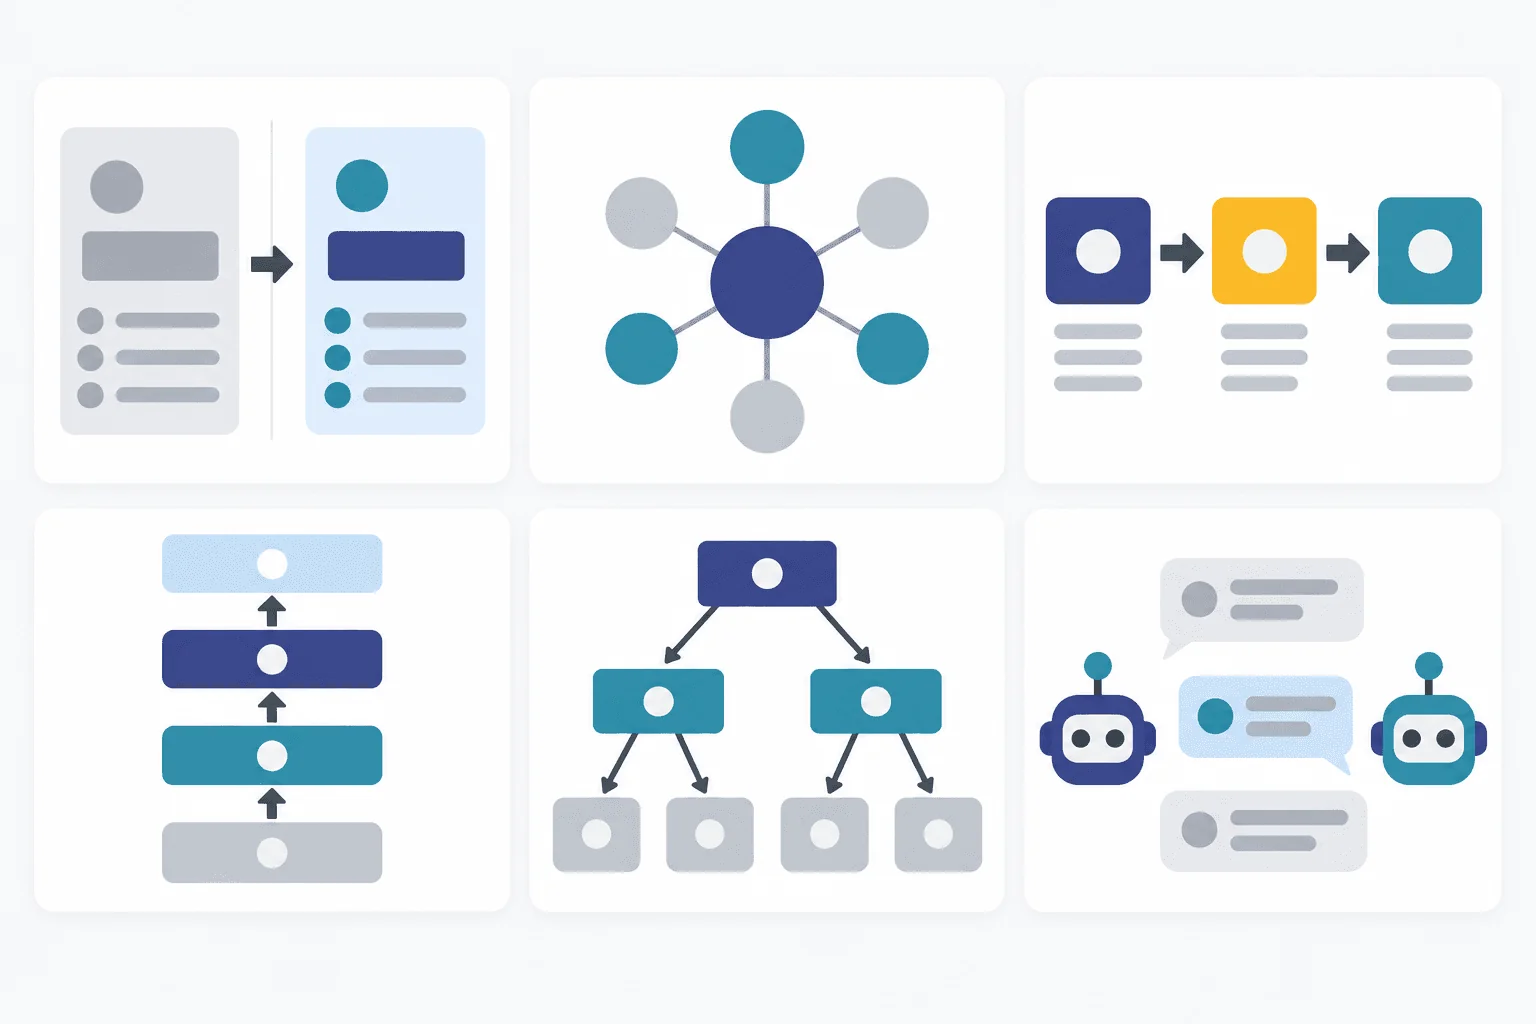
다행히 이 뼈대는 반복됩니다. 저희는 Top-Conf Figure Gallery의 메타데이터를 살펴봤습니다. ICLR, ICML, NeurIPS, CVPR, ACL, AAAI에서 2023~2025년 사이에 나온 Figure 1과 티저 그림 2,298장을 사람이 직접 검토해 모은 오픈 컬렉션인데, 살펴보니 반복되는 레이아웃은 늘 같은 여섯 가지였습니다. 이 글에서는 각 레이아웃을 ACL 논문의 실제 그림과 함께 살펴보고, 그 그림에서 무엇을 빌려 쓸 만한지 짚은 다음, 바로 고쳐 쓸 수 있는 레이아웃 프롬프트를 하나씩 붙입니다.
2,298장의 Figure 1이 보여주는 공통점 두 가지
그림을 그리기 전에 알아두면 좋은 숫자가 갤러리 데이터 파일에 두 개 있습니다.
Figure 1은 가로로 긴 배너입니다. 2,298장 전체의 가로세로 비율 중앙값은 2.35:1입니다. 94%는 1.5:1보다 가로가 길고, 세로가 더 긴 그림은 1%도 되지 않습니다. 이유는 단순합니다. 개요 그림은 보통 1페이지나 2페이지 맨 위에서 두 칼럼을 다 차지하기 때문에, 정작 부족한 자원은 높이입니다. 정사각형 캔버스에 구성했다가 나중에 눌러 넣으면 라벨이 안 보이게 됩니다. 처음부터 가로로 넓게 시작하세요.
벤치마크 개요 그림의 비중이 커지고 있습니다. 갤러리는 그림마다 시각적 패턴 태그를 붙여둡니다. taxonomy(태스크, 역량, 데이터셋 개요) 태그가 붙은 그림은 2023년 2%에서 2024~2025년에는 8%로 늘었고, framework(다중 모듈, 에이전트 시스템) 그림은 6%에서 9%로 늘었습니다. 이 흐름은 최근 이 분야가 무엇을 더 많이 발표해 왔는지와 맞아떨어집니다. 벤치마크가 늘고, 에이전트가 늘고 있는 것이죠.
다만 이 숫자를 과도하게 해석하지 않도록 한 가지는 짚고 넘어가겠습니다. 이 갤러리는 한 명의 관리자가 디자인 품질을 기준으로 골라낸 큐레이션 컬렉션이고, 학회·연도별 할당량과 패턴별 층화를 적용해 선별되었으며, 그중 46%는 뭐든 다 담는 태그인 teaser가 붙어 있습니다. 위의 패턴 비율은 이 갤러리를 설명하는 것이지, 이 학회들에 실린 모든 논문을 설명하는 것은 아닙니다. 가로세로 비율 수치는 태그와 무관합니다.
1. 전후 대비형 (conceptual)
적합한 경우: 여러분의 기여가 접근 방식 자체의 전환이고, 이를 가장 빠르게 설명하는 방법이 기존 방식의 실패와 새 방식의 성공을 나란히 보여주는 것일 때입니다.
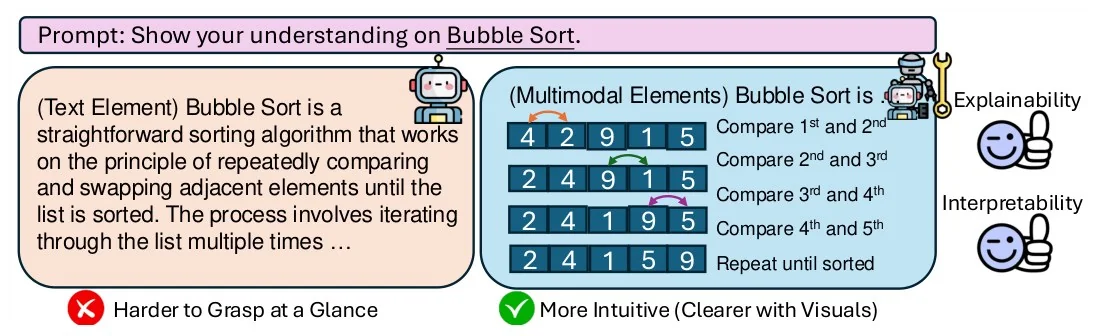
"TheoremExplainAgent: Towards Video-based Multimodal Explanations for LLM Theorem Understanding"의 Figure 1, Ku et al., ACL 2025. 논문. CC BY 4.0; 크롭 및 리사이즈.
빌려 쓸 만한 점:
- 맨 위에 걸쳐 있는 공통 입력 바(프롬프트) 하나로, 두 패널이 같은 질문에 답하고 있다는 걸 한눈에 보여줍니다.
- 크기와 모양이 완전히 같은 두 패널. 다른 건 채우기 색과 내용뿐이라서, 비교가 한눈에 공정해 보입니다.
- 각 패널 아래에 다섯 단어 안팎의 결론을 X 표시와 체크 표시와 함께 적어둡니다. 2초만 훑어봐도 주장은 전달됩니다.
- 예시는 일부러 아주 단순한 것(버블 정렬)을 골랐습니다. 이 그림이 파는 건 난이도가 아니라 아이디어입니다.
Wide two-panel comparison figure. A full-width input bar on top.
Left panel: the existing approach, muted colour, ends in a short
negative verdict with a cross. Right panel: our approach, same size,
accent colour, ends in a short positive verdict with a tick.
Same toy example in both panels. Flat vector style, white background.
2. 계층형 프레임워크 (framework)
적합한 경우: 여러 부품이 협력해서 동작하는 시스템, 특히 에이전트처럼 독자가 "만들어지는 구조"와 "그 구조를 만드는 메커니즘"을 동시에 봐야 하는 경우입니다.
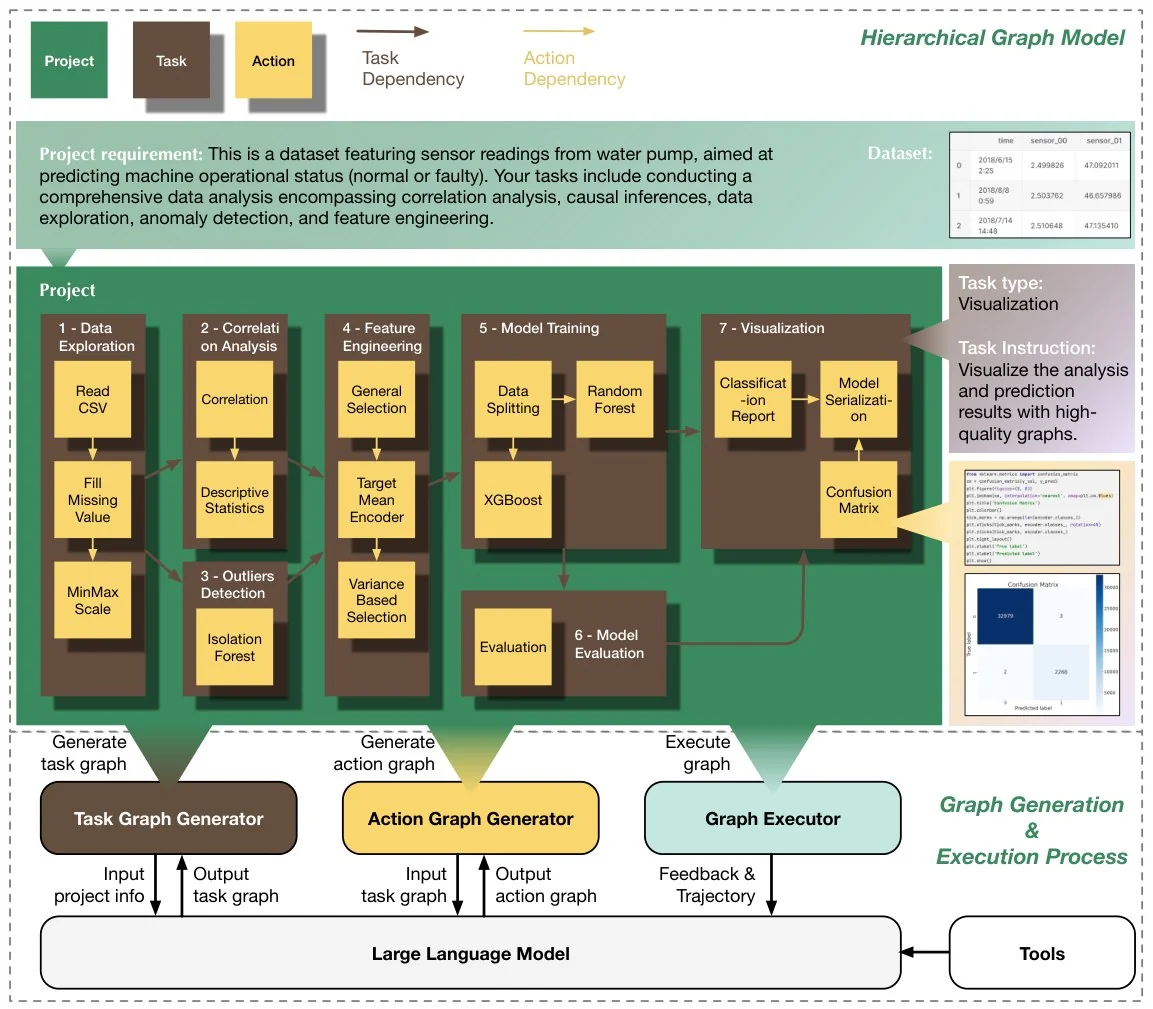
"Data Interpreter: An LLM Agent for Data Science"의 Figure 1, Hong et al., Findings of ACL 2025. 논문. CC BY 4.0; 크롭 및 리사이즈.
빌려 쓸 만한 점:
- 범례가 왼쪽 위에 가장 먼저 나옵니다. project, task, action 세 가지 색 견본으로요. 이후로는 색상만으로 계층을 표현해서 어떤 박스에도 유형 라벨이 필요 없습니다.
- 보통 화살표가 하는 일을 중첩 구조가 대신합니다. action 노드는 task 노드 안에, task 노드는 다시 project 패널 안에 들어갑니다.
- 태스크 하나를 오른쪽으로 꺼내 확대합니다. 전체 개요는 깔끔하게 유지하면서, 인스턴스 하나로 실제 디테일을 보여줍니다.
- 기반이 되는 요소는 맨 아래에 둡니다. LLM과 도구는 폭 전체를 차지하는 납작한 막대로 그려집니다. 다른 모든 것이 딛고 서 있는 것들은 바닥처럼 그리는 것이죠.
Wide system overview figure. Top-left legend with three colour swatches
for three node types. Centre: a large panel containing a nested graph,
small nodes inside medium group boxes. Right: one group enlarged as a
zoom-in callout. Bottom: three module boxes standing on two full-width
base bars. Flat vector style, restrained palette, white background.
3. 확대 컷을 포함한 파이프라인 (pipeline)
적합한 경우: 방법이 여러 단계로 이어져 있고, 각 단계 내부에도 보여줄 가치가 있는 세부 내용이 있을 때입니다. 다만 이 레이아웃은 가장 쉽게 빽빽해지는 유형이기도 합니다. 각 단계가 저마다 모든 걸 다 보여주고 싶어 하기 때문입니다.
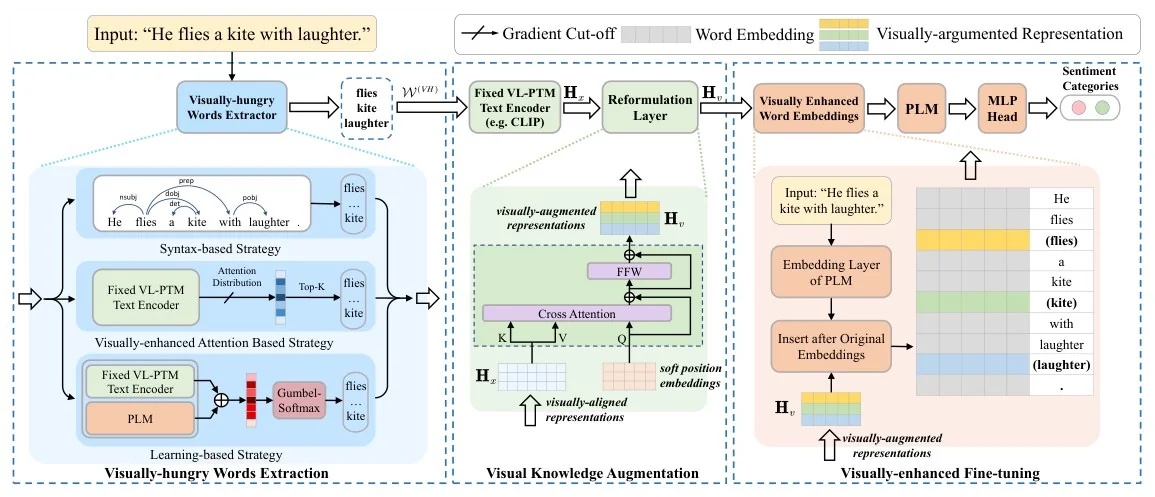
"Visually-augmented pretrained language models for NLP tasks without images"의 Figure 1, Guo et al., ACL 2023. 논문. CC BY 4.0; 크롭 및 리사이즈.
빌려 쓸 만한 점:
- 읽는 층위가 두 개입니다. 위쪽 띠는 입력 문장부터 예측까지 방법 전체를 한 줄로 보여주고, 아래 세 패널은 더 깊이 들어가고 싶은 독자를 위한 것입니다.
- 각 단계는 고유한 배경 색조를 가지며, 위쪽 띠에 있는 모듈의 색조는 그것을 설명하는 아래 패널과 일치합니다. 색이 곧 색인 역할을 합니다.
- 단계 이름은 각 패널 아래쪽에 굵게, 마치 캡션처럼 적혀 있어서 모듈 라벨과 자리를 다투지 않습니다.
- 같은 예시 문장이 모든 단계를 관통합니다. 독자는 표기법을 해독하는 대신 예시 하나를 따라가면 됩니다.
Wide pipeline figure with two levels. Top: a thin left-to-right strip of
about seven modules joined by arrows, from an input sentence to an output.
Below: three dashed panels side by side, each zooming into one stage,
each with its own pale background tint matching its module above, bold
stage name at the bottom of each panel. One running example throughout.
4. 색상으로 구분한 아키텍처 (architecture)
적합한 경우: 기여가 모델 내부에 있을 때입니다. 어떤 블록이 있는지, 어떤 것이 학습되는지, 어떤 것이 공유되는지가 핵심일 때요.
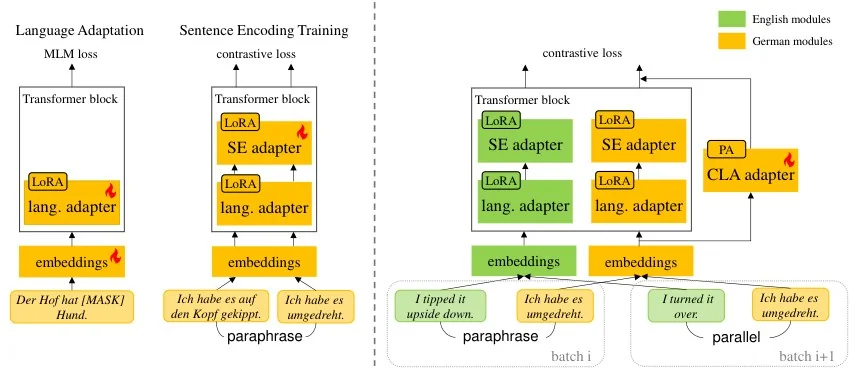
"Modular Sentence Encoders: Separating Language Specialization from Cross-Lingual Alignment"의 Figure 1, Huang et al., ACL 2025. 논문. CC BY 4.0; 크롭 및 리사이즈.
빌려 쓸 만한 점:
- 두 가지 색, 두 가지 의미: 초록은 영어, 노랑은 독일어입니다. 그림의 다른 부분은 전혀 색이 들어가지 않아서, 이 대응 관계는 바로 학습됩니다.
- 작은 불꽃 표시가 지금 학습 중인 부분을 나타냅니다. "학습 가능한가, 고정되어 있는가"는 아키텍처 그림을 보는 사람이라면 누구나 묻는 질문인데, 여기서는 글자 하나 없이 답합니다.
- 데이터는 아래에서 위로 흐르고, 입력은 이탤릭체로 쓴 실제 문장입니다. 실제 입력이 있으니 추상적인 블록도 구체적으로 느껴집니다.
- 세로 점선 하나가 학습 단계와 최종 구성을 구분합니다. 모든 걸 테두리로 감싸는 대신, 여백과 선 하나로 해결한 것이죠.
Wide model architecture figure, data flowing bottom to top. Rounded
blocks stacked inside outlined transformer containers. Exactly two
accent colours, each standing for one data source, defined in a small
top-right legend. A small flame icon on trainable blocks. Example input
sentences in italics along the bottom. A dashed vertical line separating
training stages on the left from the final configuration on the right.
5. 의사결정 트리형 분류 체계 (taxonomy)
적합한 경우: 서베이, 실증 연구, 벤치마크처럼 기여 자체가 "지도"인 경우입니다.
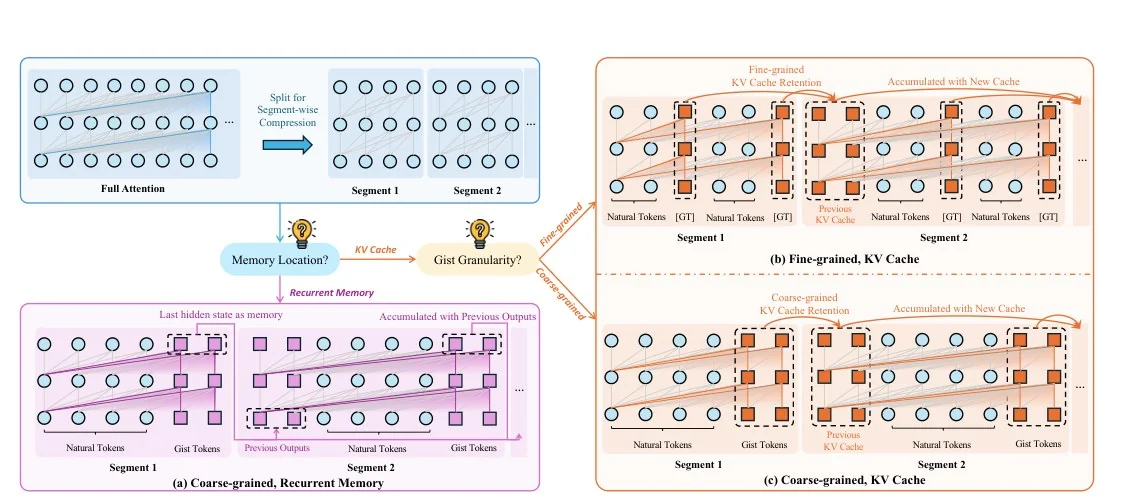
"A Silver Bullet or a Compromise for Full Attention? A Comprehensive Study of Gist Token-based Context Compression"의 Figure 1, Deng et al., ACL 2025. 논문. CC BY 4.0; 크롭 및 리사이즈.
빌려 쓸 만한 점:
- 분류 체계를 이름의 나열이 아니라, 그 분류를 만들어내는 질문("Memory location?", "Gist granularity?")으로 그려냅니다. 독자는 세 계열이 있다는 사실뿐 아니라 왜 세 계열인지도 알게 됩니다.
- 각 리프는 동일한 시각 문법(같은 토큰 원, 같은 구간)으로 그려진 완전한 패널이라서, 계열 간 차이만이 유일하게 달라지는 요소입니다.
- 가지의 색은 그대로 이어받습니다. 보라색 가지는 보라색 패널로, 주황색 가지는 주황색 패널들로 이어집니다.
- 베이스라인은 따로 떨어져 왼쪽 위에 중립적인 파란색으로 자리 잡습니다. 경쟁 대상이 아니라 기준점이라는 뜻입니다.
Wide taxonomy figure. Top-left: a neutral baseline panel. Centre: two
small rounded decision nodes phrased as questions, with labelled branches.
Each branch leads to a large panel showing one method family, all panels
drawn with identical visual elements so only the differences stand out.
Panel colour matches its branch colour.
6. 예시 기반 티저 (teaser)
적합한 경우: 태스크 자체가 새로워서, 어떤 방법을 설명하기 전에 독자가 그 인스턴스 하나를 처음부터 끝까지 봐야 이해가 되는 경우입니다.
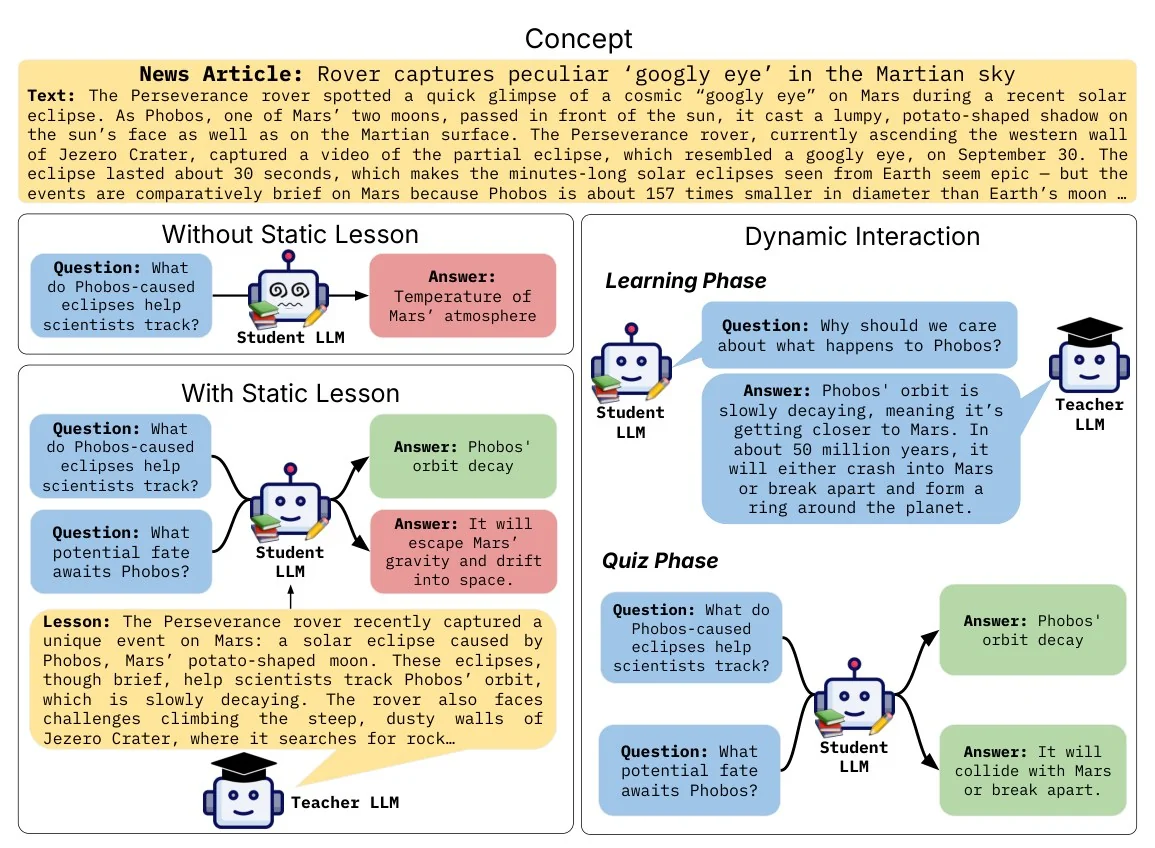
"INTERACT: Enabling Interactive, Question-Driven Learning in Large Language Models"의 Figure 1, Kendapadi et al., ACL 2025. 논문. CC BY 4.0; 크롭 및 리사이즈.
빌려 쓸 만한 점:
- 네 가지 색이 각각 고정된 역할을 맡습니다. 노랑은 원문, 파랑은 질문, 초록은 정답, 빨강은 오답입니다. 문장을 하나도 읽지 않아도 각 패널의 결과를 알 수 있습니다.
- 베이스라인 조건들은 왼쪽에 쌓아두고, 제안하는 설정은 오른쪽 절반 전체를 차지합니다. 면적이 곧 강조입니다.
- 반복해서 등장하는 캐릭터 둘(학생과 교사)이, 원래라면 한 문단이 필요했을 역할 설명을 대신합니다.
- 이 그림은 대부분의 Figure 1보다 세로로 깁니다. 그래야만 합니다. 대화는 세로 공간을 필요로 하니까요. 내용이 대화라면 가로로 긴 배너 규칙은 깨도 됩니다.
Worked-example figure. Full-width source text box on top in pale yellow.
Left column: two stacked baseline panels. Right column, twice as wide:
the proposed setting in two phases. Speech-bubble boxes colour-coded by
role: blue questions, green correct answers, red wrong answers. Two small
recurring robot characters, one with a graduation cap.
어떤 것을 고를까
| 논문의 한 줄 스토리가... | 여기서 시작 |
|---|---|
| "기존 방식은 여기서 실패하지만, 우리 방식은 그렇지 않다" | 전후 대비형 |
| "여러 구성 요소가 협력해 X를 해낸다" | 계층형 프레임워크 |
| "입력이 A, B, C 단계를 거쳐 간다" | 확대 컷을 포함한 파이프라인 |
| "모델의 이 부분을 바꿨다" | 색상으로 구분한 아키텍처 |
| "이 분야는 이렇게 구성되어 있다" | 의사결정 트리형 분류 체계 |
| "새로운 태스크다. 인스턴스 하나를 보라" | 예시 기반 티저 |
그다음은 여섯 가지 모두에 적용되는 점검 사항 세 가지입니다. 내용이 대화가 아니라면 대략 21:9 비율로 구성하세요. 모든 색에 딱 하나의 의미만 부여하고, 그 의미를 범례에 넣거나 누가 봐도 알 수 있게 만드세요. 그림을 두 칼럼짜리 페이지 너비로 줄여보고, 읽을 수 없는 라벨은 삭제하거나 키우세요.
베낄 것은 그림이 아니라 골격이다
위에서 다룬 내용은 전부 정보 위계, 여백, 읽는 순서에 관한 것이고, 이런 것들은 누구의 소유물도 아닙니다. 하지만 그림 자체는 저자의 것입니다. 이 글에 실린 여섯 장의 그림은 ACL Anthology가 2016년 이후 게재물에 적용하는 CC BY 4.0 라이선스에 따라 각 그림 아래에 출처와 링크를 표시하고 재수록한 것입니다. 다른 학회의 그림을 재사용하고 싶다면 먼저 그 논문의 라이선스를 확인하세요. 어떤 그림이 갤러리에 있다고 해서 자유롭게 써도 된다는 뜻은 아닙니다.
각 레이아웃의 더 많은 예시를 보고 싶다면, Top-Conf Figure Gallery에서 학회, 연도, 패턴별로 2,298장 전체를 필터링해 볼 수 있습니다. 이 갤러리를 제대로 활용하는 법은 Top-Conf Figure Gallery 활용 가이드로 정리해 두었습니다.
PaperBanana가 도움이 되는 지점
원하는 골격이 정해지면, 남은 일은 그걸 실제로 그리는 것뿐입니다. PaperBanana는 텍스트 설명만으로 바로 게재할 수 있는 학술 그림을 생성합니다. 위의 레이아웃 프롬프트 중 하나를 붙여넣고, 일반적인 부분을 여러분의 모듈과 예시로 바꾼 다음, 종횡비로 21:9를 선택하면 됩니다. 공동 저자가 라벨 하나를 옮기고 싶어 하면, 결과물을 완전히 편집 가능한 SVG로 변환해서 직접 옮기면 됩니다.
그림 출처
여섯 장 모두 저작권은 각 저자에게 있으며, ACL Anthology를 통해 CC BY 4.0 라이선스로 제공됩니다. 논문 PDF에서 잘라내 크기를 조정했고, Top-Conf Figure Gallery를 통해 찾았습니다.
- Max Ku, Cheuk Hei Chong, Jonathan Leung, Krish Shah, Alvin Yu, Wenhu Chen. TheoremExplainAgent. ACL 2025.
- Sirui Hong, Yizhang Lin, Bang Liu, Bangbang Liu, Binhao Wu, Ceyao Zhang, Danyang Li, Jiaqi Chen, Jiayi Zhang, Jinlin Wang, Li Zhang, Lingyao Zhang, Min Yang, Mingchen Zhuge, Taicheng Guo, Tuo Zhou, Wei Tao, Robert Tang, Xiangtao Lu, Xiawu Zheng, Xinbing Liang, Yaying Fei, Yuheng Cheng, Yongxin Ni, Zhibin Gou, Zongze Xu, Yuyu Luo, Chenglin Wu. Data Interpreter: An LLM Agent for Data Science. Findings of ACL 2025.
- Hangyu Guo, Kun Zhou, Wayne Xin Zhao, Qinyu Zhang, Ji-Rong Wen. Visually-augmented pretrained language models for NLP tasks without images. ACL 2023.
- Yongxin Huang, Kexin Wang, Goran Glavaš, Iryna Gurevych. Modular Sentence Encoders. ACL 2025.
- Chenlong Deng, Zhisong Zhang, Kelong Mao, Shuaiyi Li, Xinting Huang, Dong Yu, Zhicheng Dou. A Silver Bullet or a Compromise for Full Attention? ACL 2025.
- Aum Kendapadi, Kerem Zaman, Rakesh R Menon, Shashank Srivastava. INTERACT. ACL 2025.