主图首先是排版问题,其次才是画图问题
大多数人打开画图软件的时候,主图里要放什么其实已经想清楚了:有哪些模块、箭头怎么连、用哪个例子。卡住的是骨架:视线从哪边走到哪边,视觉中心放什么,一共分几块。真正耗时间的是这一步。
好消息是,骨架是会重复的。我们翻了一遍 Top-Conf Figure Gallery 的元数据。这是一个开源的顶会论文主图画廊,收录了 ICLR、ICML、NeurIPS、CVPR、ACL、AAAI 在 2023–2025 年间 2,298 张逐张人工复核过的 Figure 1 和 teaser。看下来,反复出现的布局就是六种。这篇文章每种配一张 ACL 论文里的真实主图,说清楚它哪里值得借鉴,再给一段可以直接改写的布局提示词。
2,298 张主图的两个共同点
动笔之前,画廊数据里有两个数字值得先知道。
主图是一条横幅。 全部 2,298 张图的宽高比中位数是 2.35:1,94% 的图宽高比超过 1.5:1,竖图不到 1%。原因很朴素:总览图通常横跨双栏、放在第一页或第二页顶部,高度才是稀缺资源。如果你在方形画布上构图、最后再压扁,标签基本都会糊掉。一开始就用宽画布。
benchmark 全景图的占比在变大。 画廊给每张图打了视觉模式标签。标为 taxonomy(任务、能力、数据集全景)的图,在 2023 年的图里占 2%,到 2024 和 2025 年占 8%;framework(多模块、智能体系统)从 6% 涨到 9%。这和这两年大家在发什么是对得上的:benchmark 更多了,agent 更多了。
也提醒一句,别把这些数字读过头:这是一位维护者按设计质量筛出来的精选集,选图时还按会议、年份设了配额并对视觉模式做了分层,而且 46% 的图挂的是兜底标签 teaser。这些模式占比描述的是这个画廊,不是这些会议的全部论文。宽高比那个数字则不依赖标签。
1. 前后对比式(conceptual)
适用场景:你的贡献是一种"换了思路",最快的讲法就是把旧方法的失败和新方法的成功并排摆出来。
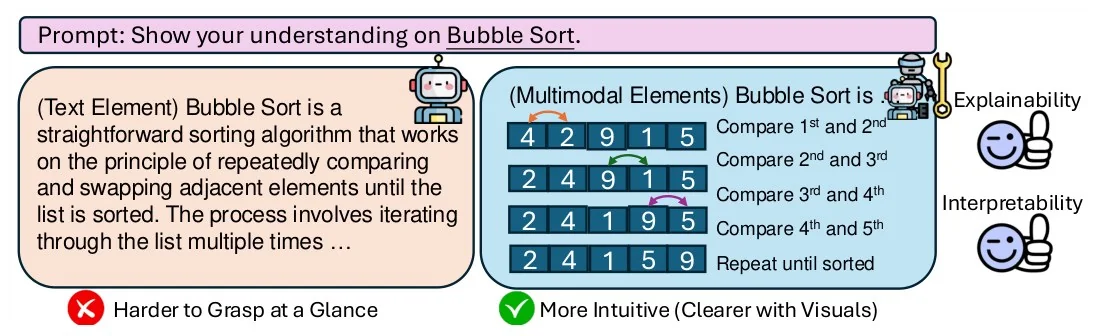
出自 "TheoremExplainAgent: Towards Video-based Multimodal Explanations for LLM Theorem Understanding" 的 Figure 1,Ku 等,ACL 2025。论文链接。CC BY 4.0;经裁剪与缩放。
值得借鉴的地方:
- 顶部一条通栏的输入条(prompt),让人一眼看出左右两块回答的是同一个问题。
- 两个面板大小、形状完全一致,只有底色和内容不同,对比显得公平。
- 结论直接写在面板下面,五个词加一个叉、一个勾。只看两秒的读者也能带走你的主张。
- 例子故意选得很简单(冒泡排序)。这张图卖的是思路,不是难度。
Wide two-panel comparison figure. A full-width input bar on top.
Left panel: the existing approach, muted colour, ends in a short
negative verdict with a cross. Right panel: our approach, same size,
accent colour, ends in a short positive verdict with a tick.
Same toy example in both panels. Flat vector style, white background.
2. 分层框架式(framework)
适用场景:系统由多个部件协作完成,尤其是 agent 类工作,读者既要看到"被构建出来的结构",也要看到"负责构建它的机制"。
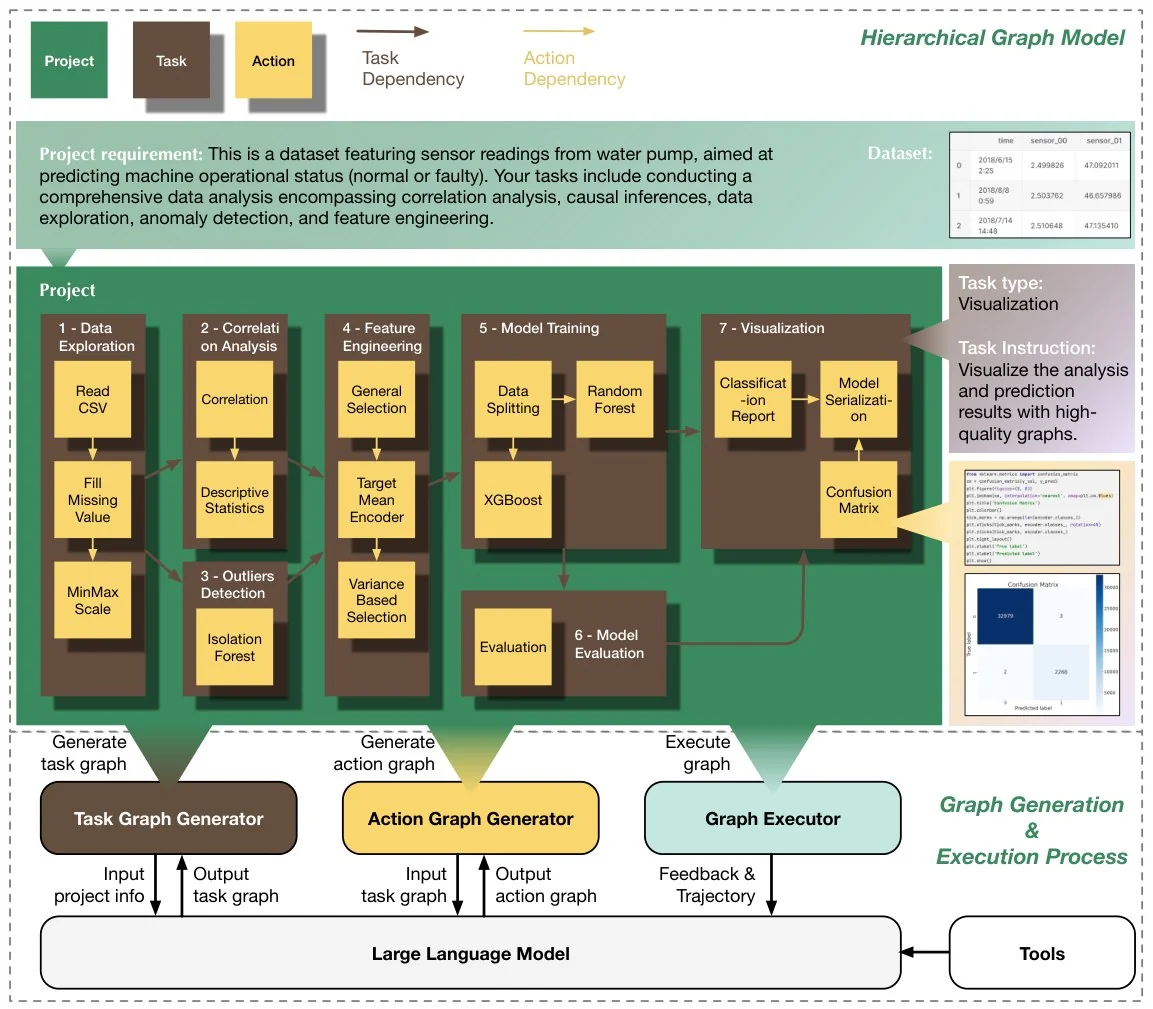
出自 "Data Interpreter: An LLM Agent for Data Science" 的 Figure 1,Hong 等,Findings of ACL 2025。论文链接。CC BY 4.0;经裁剪与缩放。
值得借鉴的地方:
- 图例放在最前面(左上角),三个色块:project、task、action。之后层级全靠颜色表达,每个方框都不用再标类型。
- 用嵌套代替箭头。action 节点画在 task 节点里面,task 节点画在 project 面板里面。
- 把其中一个 task 拉到右边放大。总览保持干净,细节由一个实例来承担。
- 地基画在底部:LLM 和 Tools 是两条通栏的扁条。所有东西都踩在上面的部件,就画成地板。
Wide system overview figure. Top-left legend with three colour swatches
for three node types. Centre: a large panel containing a nested graph,
small nodes inside medium group boxes. Right: one group enlarged as a
zoom-in callout. Bottom: three module boxes standing on two full-width
base bars. Flat vector style, restrained palette, white background.
3. 带放大的流程式(pipeline)
适用场景:方法是一串阶段,而且每个阶段内部都有值得展示的细节。它也是最容易画挤的一种,因为每个阶段都想把所有东西摆出来。
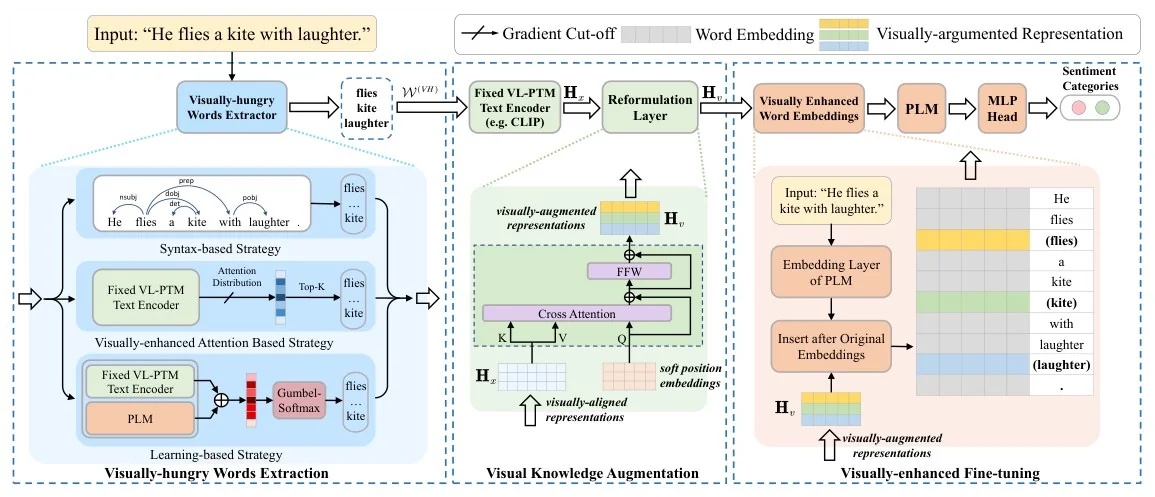
出自 "Visually-augmented pretrained language models for NLP tasks without images" 的 Figure 1,Guo 等,ACL 2023。论文链接。CC BY 4.0;经裁剪与缩放。
值得借鉴的地方:
- 两个阅读层级。顶部那一条就是整个方法的一句话版本,从输入句子到预测结果;下面三个面板留给想深入看的人。
- 每个阶段独占一种底色,顶部模块的颜色和下方对应面板的底色一致。颜色就是索引。
- 阶段名用粗体放在每个面板底部,像图注一样,不和模块标签抢位置。
- 同一个示例句子贯穿所有阶段。读者追着一个例子走,不用去解码符号。
Wide pipeline figure with two levels. Top: a thin left-to-right strip of
about seven modules joined by arrows, from an input sentence to an output.
Below: three dashed panels side by side, each zooming into one stage,
each with its own pale background tint matching its module above, bold
stage name at the bottom of each panel. One running example throughout.
4. 配色编码的架构式(architecture)
适用场景:贡献在模型内部——有哪些模块、哪些参与训练、哪些是共享的。
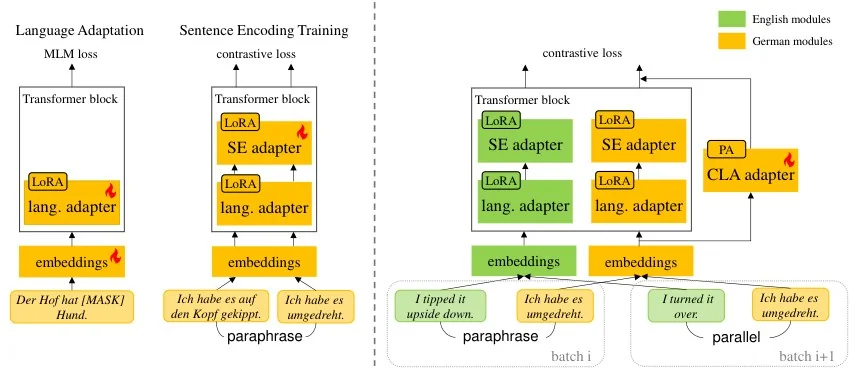
出自 "Modular Sentence Encoders: Separating Language Specialization from Cross-Lingual Alignment" 的 Figure 1,Huang 等,ACL 2025。论文链接。CC BY 4.0;经裁剪与缩放。
值得借鉴的地方:
- 两种颜色,两个含义:绿色是英语,黄色是德语。图里再没有别的彩色,所以这个对应关系一秒就记住了。
- 一个小火焰标出正在训练的部分。"哪些训练、哪些冻结"是每个看架构图的人都会问的问题,这里一个字没写就回答了。
- 数据自下而上流动,输入是斜体的真实句子。真实输入让抽象的方块落了地。
- 一条竖直虚线把训练阶段和最终配置隔开。靠留白和一条线,而不是给所有东西都套一个框。
Wide model architecture figure, data flowing bottom to top. Rounded
blocks stacked inside outlined transformer containers. Exactly two
accent colours, each standing for one data source, defined in a small
top-right legend. A small flame icon on trainable blocks. Example input
sentences in italics along the bottom. A dashed vertical line separating
training stages on the left from the final configuration on the right.
5. 决策树式全景图(taxonomy)
适用场景:综述、实证研究、benchmark——贡献本身就是那张"地图"。
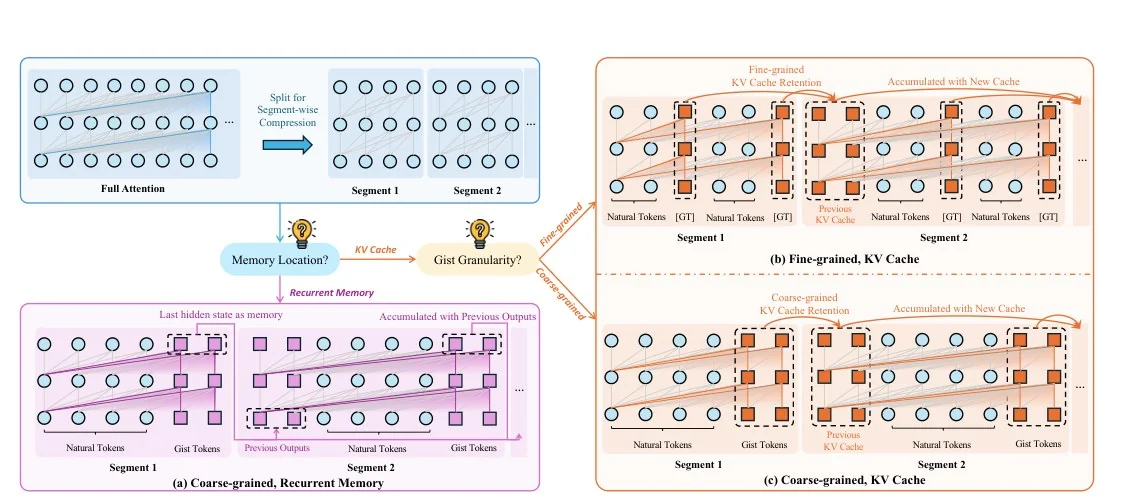
出自 "A Silver Bullet or a Compromise for Full Attention? A Comprehensive Study of Gist Token-based Context Compression" 的 Figure 1,Deng 等,ACL 2025。论文链接。CC BY 4.0;经裁剪与缩放。
值得借鉴的地方:
- 分类体系是用"产生它的问题"画出来的("Memory location?""Gist granularity?"),而不是一串名字。读者知道的不只是有三类,还有为什么是三类。
- 每个叶子都是一个完整面板,用同一套视觉语法(同样的 token 圆圈、同样的分段),于是各类之间的差异成了唯一变化的东西。
- 分支颜色是继承的:紫色分支通向紫色面板,橙色分支通向橙色面板。
- 基线单独放在左上角,用中性的蓝色。它是参照点,不是竞争对手。
Wide taxonomy figure. Top-left: a neutral baseline panel. Centre: two
small rounded decision nodes phrased as questions, with labelled branches.
Each branch leads to a large panel showing one method family, all panels
drawn with identical visual elements so only the differences stand out.
Panel colour matches its branch colour.
6. 完整示例式(teaser)
适用场景:任务本身是新的,读者得先从头到尾看完一个实例,之后讲方法才听得懂。
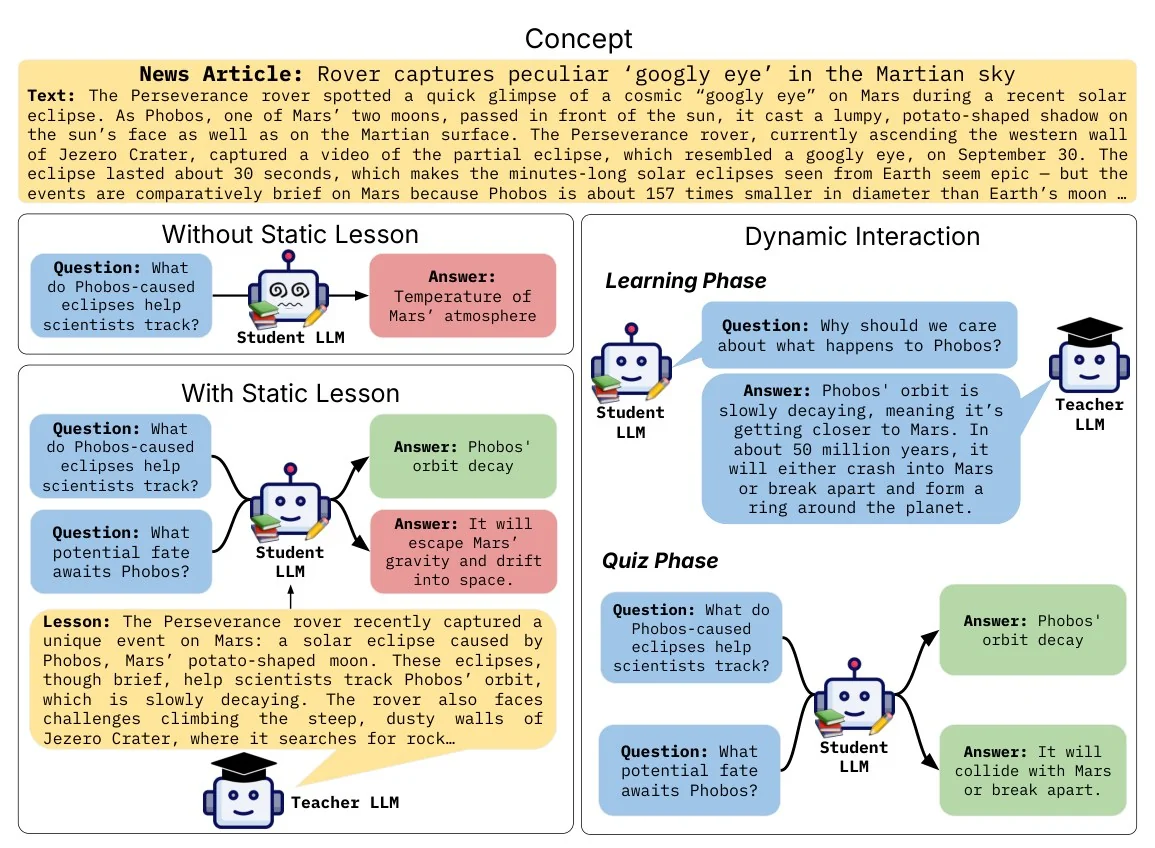
出自 "INTERACT: Enabling Interactive, Question-Driven Learning in Large Language Models" 的 Figure 1,Kendapadi 等,ACL 2025。论文链接。CC BY 4.0;经裁剪与缩放。
值得借鉴的地方:
- 四种颜色各司其职:黄色是原文,蓝色是问题,绿色是答对,红色是答错。不读任何一句话,也能看出每个面板的结果。
- 基线条件叠在左边,自己提出的设定独占整个右半边。面积就是强调。
- 两个反复出现的角色(学生和老师)替掉了本来要写一段的角色定义。
- 它比大多数主图都高,而且必须高:对话需要纵向空间。内容是对话的时候,可以打破"横幅"规则。
Worked-example figure. Full-width source text box on top in pale yellow.
Left column: two stacked baseline panels. Right column, twice as wide:
the proposed setting in two phases. Speech-bubble boxes colour-coded by
role: blue questions, green correct answers, red wrong answers. Two small
recurring robot characters, one with a graduation cap.
怎么选
| 如果你论文的一句话故事是…… | 从这种开始 |
|---|---|
| "旧方法在这里不行,我们的可以" | 前后对比式 |
| "几个部件协作完成 X" | 分层框架式 |
| "输入依次经过 A、B、C 三个阶段" | 带放大的流程式 |
| "我们改了模型的这一部分" | 配色编码的架构式 |
| "这个领域是这样组织起来的" | 决策树式全景图 |
| "这是个新任务,先看一个实例" | 完整示例式 |
选完之后,有三条检查对六种布局都适用。除非内容是对话,否则按 21:9 左右构图。每种颜色只表示一个含义,要么写进图例,要么让它一眼就能看出来。把图缩到双栏论文的实际宽度,看不清的标签要么放大,要么删掉。
借骨架,不借画
上面讲的全是信息层级、留白和阅读顺序,这些东西不属于任何人。但图本身属于作者。本文的六张图依据 ACL Anthology 对 2016 年以后材料采用的 CC BY 4.0 许可转载,每张图下面都有署名和原文链接。如果你想复用其他会议的图,先查那篇论文的许可;一张图出现在某个画廊里,不代表它可以随便用。
想看每种布局的更多例子,可以去 Top-Conf Figure Gallery,按会议、年份、视觉模式筛选全部 2,298 张图。我们另外写了一篇 Top-Conf Figure Gallery 使用指南与数据解读。
PaperBanana 能帮上什么
骨架选定以后,剩下的就是把它画出来。PaperBanana 根据一段文字描述生成可直接发表的学术配图:把上面任意一段布局提示词贴进去,把通用的部分换成你的模块和你的示例,宽高比选 21:9。合作者想挪一个标签的时候,可以把结果转成完全可编辑的 SVG,自己动手挪。
图片署名
六张图的版权均归原作者所有,经 ACL Anthology 以 CC BY 4.0 许可发布;图片自论文 PDF 裁剪并缩放,通过 Top-Conf Figure Gallery 检索到。
- Max Ku, Cheuk Hei Chong, Jonathan Leung, Krish Shah, Alvin Yu, Wenhu Chen. TheoremExplainAgent. ACL 2025.
- Sirui Hong, Yizhang Lin, Bang Liu, Bangbang Liu, Binhao Wu, Ceyao Zhang, Danyang Li, Jiaqi Chen, Jiayi Zhang, Jinlin Wang, Li Zhang, Lingyao Zhang, Min Yang, Mingchen Zhuge, Taicheng Guo, Tuo Zhou, Wei Tao, Robert Tang, Xiangtao Lu, Xiawu Zheng, Xinbing Liang, Yaying Fei, Yuheng Cheng, Yongxin Ni, Zhibin Gou, Zongze Xu, Yuyu Luo, Chenglin Wu. Data Interpreter: An LLM Agent for Data Science. Findings of ACL 2025.
- Hangyu Guo, Kun Zhou, Wayne Xin Zhao, Qinyu Zhang, Ji-Rong Wen. Visually-augmented pretrained language models for NLP tasks without images. ACL 2023.
- Yongxin Huang, Kexin Wang, Goran Glavaš, Iryna Gurevych. Modular Sentence Encoders. ACL 2025.
- Chenlong Deng, Zhisong Zhang, Kelong Mao, Shuaiyi Li, Xinting Huang, Dong Yu, Zhicheng Dou. A Silver Bullet or a Compromise for Full Attention? ACL 2025.
- Aum Kendapadi, Kerem Zaman, Rakesh R Menon, Shashank Srivastava. INTERACT. ACL 2025.